KI-Erkennungveröffentlicht am 25. Juni 2026
Wie KI-Detektoren funktionieren: Perplexität und Burstiness erklärt
KI-Detektoren lesen Bedeutung nicht so, wie ein Mensch es tut. Stattdessen messen sie statistische Muster darin, wie Wörter gewählt und angeordnet werden. Zwei dieser Muster, Perplexität und Burstiness, leisten den größten Teil der Arbeit. Wer sie versteht, kann einen Wert als zu prüfenden Hinweis lesen, nicht als endgültiges Urteil.
Was Perplexität misst
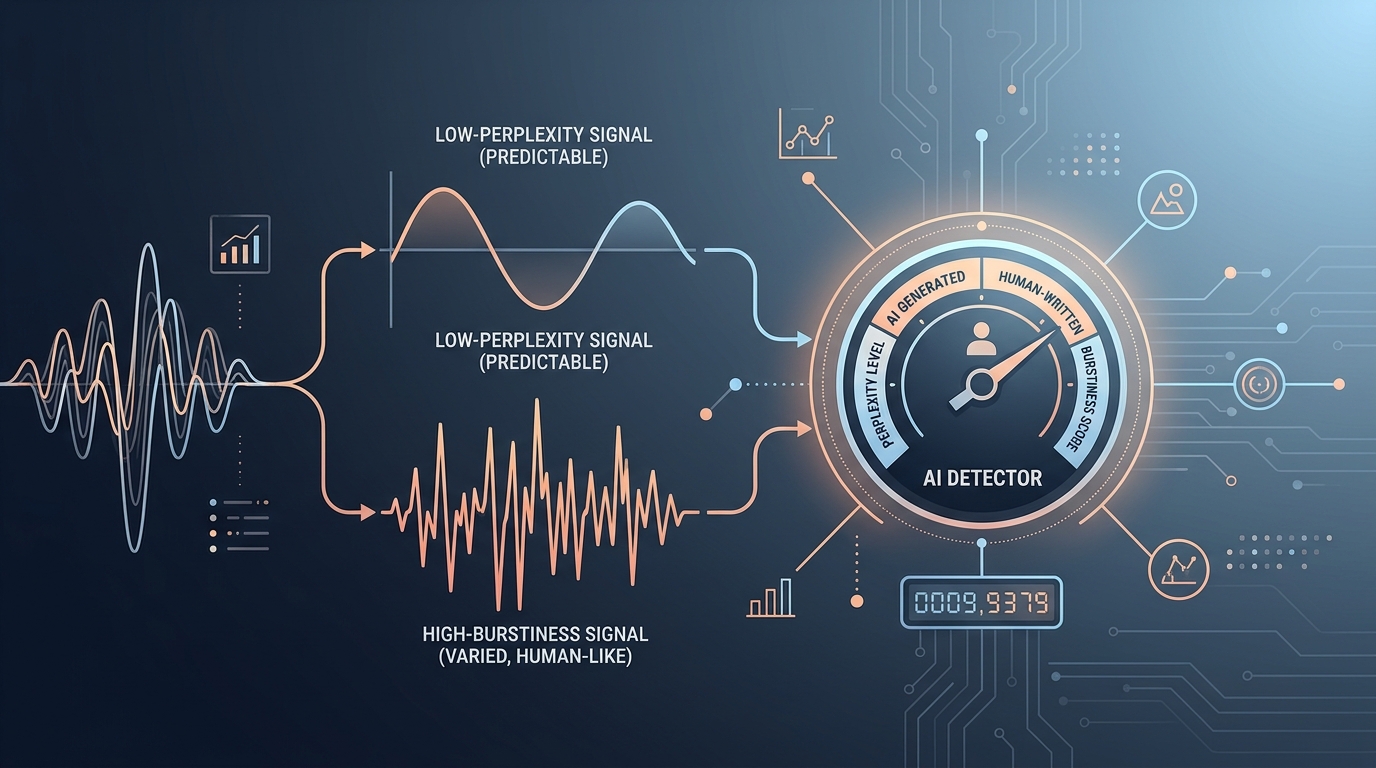
Perplexität beschreibt, wie vorhersehbar eine Textstelle für ein Sprachmodell ist. Der Detektor fragt im Grunde, wie überrascht ein Modell von jedem nächsten Wort wäre. Folgt ein Text immer wieder dem wahrscheinlichsten Pfad, ist die Perplexität niedrig. Sind die Wortwahlen unerwartet, eigenwillig oder ungleichmäßig, steigt die Perplexität.
Das ist wichtig, weil Modelle wie GPT-5, Claude und Gemini darauf trainiert sind, flüssigen Text mit hoher Wahrscheinlichkeit zu erzeugen. Ihre Standardausgabe ist oft glatt und selbstsicher, was tendenziell als niedrige Perplexität gewertet wird. Menschliche Entwürfe schweifen dagegen stärker ab und hinterlassen eine weniger vorhersehbare Spur.
Was Burstiness misst
Burstiness betrachtet die Variation zwischen Sätzen statt innerhalb einzelner Wortwahlen. Menschliches Schreiben ist von Natur aus ungleichmäßig: Ein langer, verschlungener Satz kann neben einem kurzen stehen. Der Rhythmus verschiebt sich, die Komplexität steigt und fällt, und die Struktur variiert.
Maschinell erzeugter Text hält oft einen gleichmäßigeren Takt, mit Sätzen ähnlicher Länge und einheitlichem Aufbau. Niedrige Burstiness, gepaart mit niedriger Perplexität, ist ein häufiges Muster in KI-gestützten Entwürfen. Unsere Seite zur Methodik beschreibt, wie diese Signale kombiniert werden.
Warum diese Signale keine Urteile sind
Keines der beiden Maße beweist die Urheberschaft. Mehrere alltägliche Situationen drängen menschliches Schreiben in KI-ähnliche Muster:
- Übersetzter Text wird oft glatter und einheitlicher als das Original.
- Technisches oder schablonenhaftes Schreiben folgt festen Strukturen, die die Burstiness senken.
- Nicht-muttersprachliches Schreiben bevorzugt mitunter einfachere, vorhersehbarere Formulierungen.
- Stark überarbeitete Entwürfe können die Ungleichmäßigkeit verlieren, die auf eine menschliche Hand hindeutet.
Wegen dieser Überschneidungen sollte ein Wert eingrenzen, wo eine prüfende Person hinschaut, und nicht das Ergebnis entscheiden. Wie sich die Sicherheit mit Stichprobenlänge und Dokumenttyp verschiebt, lesen Sie in unseren Anmerkungen zur Detektorgenauigkeit.
Wie GPTZeroAI sie anwendet
Der KI-Detektor meldet Signale auf Passagenebene neben einer Gesamtschätzung, sodass Prüfende sehen können, wo sich Vorhersehbarkeit und Einheitlichkeit häufen. Kürzere Stichproben tragen mehr Unsicherheit, daher werden sehr kurze Eingaben mit Vorsicht markiert statt mit einem festen Wert. Das Ziel ist eine transparente Prüfspur, keine Anschuldigung.
Detektorsignale verantwortungsvoll nutzen
Behandeln Sie Perplexität und Burstiness als Ausgangspunkte. Vergleichen Sie markierte Passagen mit Entwürfen, Quellenangaben und der gewohnten Stimme der verfassenden Person. Halten Sie den Dokumentkontext fest, bestätigen Sie, dass die Stichprobe lang genug zur Beurteilung ist, und gehen Sie bei mehrdeutigen Ergebnissen mit einem Gespräch nach. Ein Signal gewinnt seinen Wert, wenn es zu einem fairen, dokumentierten nächsten Schritt führt.
Häufig gestellte Fragen
Was ist Perplexität bei der KI-Erkennung?
Perplexität misst, wie vorhersehbar ein Text für ein Sprachmodell ist. Eine niedrigere Perplexität bedeutet, dass die Formulierung dem wahrscheinlichsten Pfad eng folgt, ein Muster, das in KI-generiertem Schreiben häufig ist.
Was bedeutet Burstiness?
Burstiness misst die Variation in Satzlänge und Struktur über eine Passage hinweg. Menschliches Schreiben neigt zur Ungleichmäßigkeit, während maschineller Text oft einen gleichmäßigeren, einheitlicheren Rhythmus hält.
Können diese Signale falsch sein?
Ja. Übersetzung, schablonenhafte Formate, nicht-muttersprachliche Formulierungen und starke Überarbeitung können menschliches Schreiben vorhersehbar oder einheitlich wirken lassen, weshalb ein Wert ein Prüfhinweis und kein Beweis ist.
Sollte ich auf einen einzelnen Detektorwert hin handeln?
Nein. Nutzen Sie den Wert, um zu entscheiden, wo Sie genauer hinschauen, und vergleichen Sie dann Passagen mit Entwürfen, Quellenangaben und Kontext, bevor Sie zu einem Schluss kommen.
Teilen
Verwandte Beiträge
KI-Erkennung
Ein fairer, sachlicher Vergleich, wie Turnitin und GPTZeroAI an die KI-Erkennung herangehen, mit Fokus auf Workflow, Transparenz und Belege, auf die Prüfer reagieren können.
25. Juni 2026
KI-Erkennung
KI-gestützte Bewerbungen sind inzwischen weit verbreitet. Erfahren Sie, wie Recruiter KI-Erkennung als faires Signal bei der Prüfung von Lebenslauf und Anschreiben nutzen, ohne Kandidaten automatisch abzulehnen.
25. Juni 2026
KI-Erkennung
ChatGPT, Claude und Gemini hinterlassen jeweils unterschiedliche Schreibspuren. Hier erfahren Sie, was die Erkennbarkeit wirklich verändert und warum kein Modell zuverlässig unsichtbar ist.
25. Juni 2026